研究生组会:本周进展、实验结果与下周计划
根据零散的实验记录、结果表和参考文献整理成的研究生组会汇报:可编辑的实验流程图、以原生图表呈现的检索与生成结果、待解决问题和下周计划。下一周的汇报由这一份加上新的记录生成,结果更新、版式不变。
第 2 周:上周的汇报,加上本周的实验记录(Markdown)、结果表(Excel)和参考文献;第 1 周只用了后三份。
以及这些说明这是下一次组会(第 10 周,10/30)。第一个来源是上次(第 9 周)的组会汇报:保持它的页面顺序和版式,用本周的实验记录、结果表和参考文献(其余来源)更新进展、结果、问题和下周计划。在开头之后增加一页“相比上周”:上周三个未解决问题各自的进展。泄漏检查后所有数字已重算,结果页要同时列出泄漏处理前后的两套数字,不能只放好看的。 研究生组会汇报(第 10 周,10/30),由研二学生陈若向导师和课题组汇报本周进展。把实验记录、结果表和参考文献整理成清楚的进展汇报:课题与本周目标、实验流程(可编辑流程图)、检索与端到端结果(原生可编辑图表,只用结果表中的数字)、尚未解决的问题、下周计划,并在相关页面标注参考文献。采用固定、可复用的组会结构,每周同样的页面顺序和版式,下次组会只需更新数据和结论。研究与数据均为虚构,含数据页面标注“演示数据”,来源行写“来源:陈若实验记录(演示数据)”。演讲者备注要帮助讲清本周的研究故事:做了什么、发现了什么、哪里还不确定、想请老师给什么建议,不要逐字重复页面文字。
免费下载,无需登录。用 PowerPoint 打开即可随意修改。

- 风格
- 手绘笔记
- PPT 类型
- 学术研究
- 图片
- 不用图片
- 幻灯片
- 11
- PPT 语言
- 中文 (简体)
每一页,未经修改
点击幻灯片查看大图。
-
1第10周研究进展|10/30
演讲者备注
李老师、各位同学好,我是陈若,今天汇报第十周中文医疗问答 RAG 检索器领域微调的进展。接着上周对收益可靠性的疑问,这周我先剔除疑似重叠题并重算结果,再引入困难负样本,同时检查生成答案有没有检索证据支持。目前检索改善仍然存在,但人工检查发现,指标提高还不能说明答案都有依据;本次研究和数据均为虚构,仅用于演示。
-
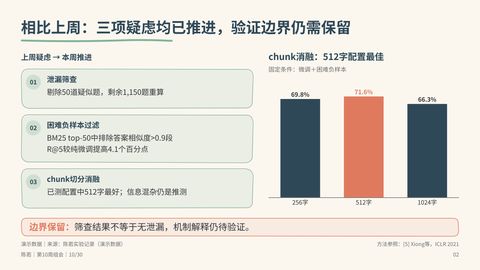
2相比上周:三项疑虑均已推进,验证边界仍需保留
演讲者备注
围绕刚才这条主线,上周留下的三个问题,这周都有了推进,但还不能说已经解决。数据方面,剔除了50道疑似重叠题,剩余1,150题上的检索和答案指标全部重算;负样本方面,对BM25候选做了答案相似度过滤,再用于训练。切分消融固定微调加困难负样本的条件,512字的Recall@5为71.6%,高于256字的69.8%和1024字的66.3%,所以当前继续使用512字。这里要保留两个边界:重叠筛查不能保证完全没有泄漏,长段落表现下降也还不能直接归因于信息混杂。
-
3本周检验:排除疑似重叠后,检索收益是否仍存在?
演讲者备注
这些进展把本周的问题从流程能否跑通,推进到了收益是否经得起检查。具体来说,我想确认剔除疑似重叠题后,领域微调的优势是否还在,再在固定生成器的条件下,观察新增训练方法是否同时改善召回、排序和最终答案。
-
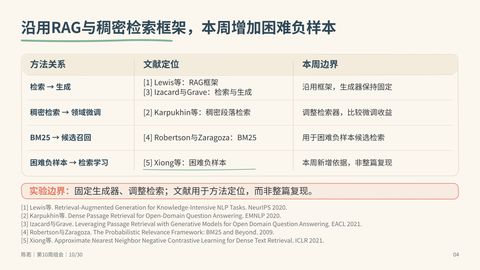
4沿用RAG与稠密检索框架,本周增加困难负样本
演讲者备注
为了回答这个问题,方法上仍然把变化集中在检索端,没有同时调整生成器。RAG和稠密段落检索提供整体框架,医疗领域微调是主要训练方向,BM25则用于提供困难负样本候选。本周新增参考的是Xiong等人的困难负样本学习工作,但这里只借鉴训练思路,并不是完整复现论文方法。这样限定范围,是为了让结果主要围绕检索方案的差异来解释。
-
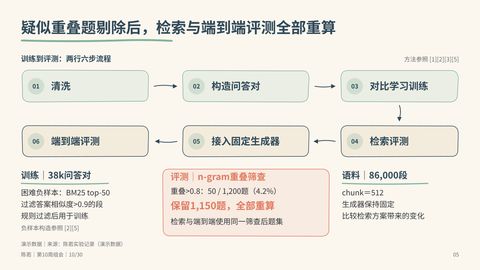
5疑似重叠题剔除后,检索与端到端评测全部重算
演讲者备注
沿着这个实验边界,这周对训练负样本和评测数据分别做了处理,两者的阈值用途不同。训练仍使用38k问答对,从BM25前50个候选段落中,排除与答案相似度大于0.9的段落,目的是减少把可回答问题的段落误当负例的风险。评测则把与训练集n-gram重叠大于0.8的题列为疑似,原来1,200题中有50题符合条件,占4.2%,剔除后对保留的1,150题全部重算。主结果使用86,000段语料和512字切分,端到端阶段保持生成器固定;这些规则是风险控制措施,不是风险已经清零的证明。
-
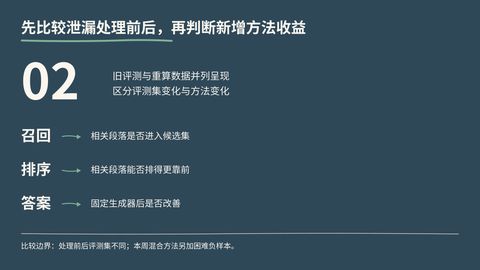
6先比较泄漏处理前后,再判断新增方法收益
演讲者备注
明确了数据和训练的变化之后,结果就需要分成两种比较来看:既有方法处理前后怎么变,以及在同一套重算评测集上新增方法是否更好。下面依次看召回、排序和答案,尤其注意跨周混合方案还增加了困难负样本,不能把所有变化都解释成剔除疑似题的影响。
-
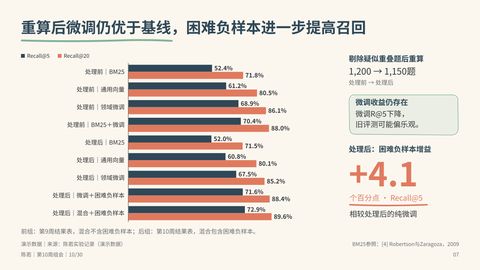
7重算后微调仍优于基线,困难负样本进一步提高召回
演讲者备注
先看召回,重算确实让既有方法的数值有所下降,但没有消除领域微调相对通用基线的优势。纯微调的Recall@5从68.9%降到67.5%,而重算后的通用基线是60.8%,说明旧评测可能偏乐观,但微调收益仍然存在。在同一套重算评测集上,加入困难负样本后达到71.6%,比纯微调高4.1个百分点,进一步混合BM25后达到72.9%。Recall@20也呈现相同方向,从纯微调的85.2%提高到88.4%,混合方案达到89.6%;不过处理前后的混合方案训练条件不同,不能直接把跨周差值当成单一因素的收益。
-
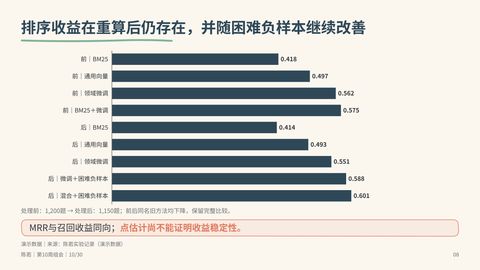
8排序收益在重算后仍存在,并随困难负样本继续改善
演讲者备注
召回提高之后,还需要确认相关段落是否排得更靠前,MRR给出的方向与召回一致。纯微调的MRR@10从处理前的0.562降到重算后的0.551,但仍高于重算基线的0.493;加入困难负样本后为0.588,混合方案为0.601。因此,当前改善不仅体现在候选覆盖上,也体现在排序上。不过这些仍然是点估计,还不能据此断言收益具有统计稳定性。
-
9固定生成器后,新检索方案的答案指标高于重算基线
演讲者备注
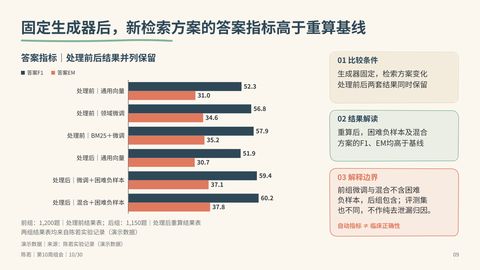
检索端两个层面的改善之后,我进一步看了固定生成器时,最终答案是否也有变化。在重算评测集上,微调加困难负样本的答案F1为59.4、EM为37.1,高于通用基线的51.9和30.7;混合方案进一步达到60.2和37.8。处理前的结果也保留下来,但旧的微调和混合方案没有困难负样本,因此跨周比较同时涉及评测集和方法变化,不能作纯去泄漏归因。更重要的是,这些自动答案指标提高,并不等于回答已经具备临床正确性或充分的证据支持。
-
10人工检查发现无依据内容,答案可靠性仍未解决
演讲者备注
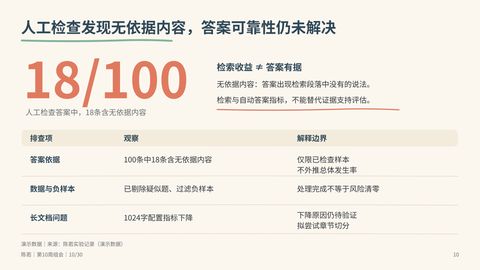
正因为自动指标不能回答证据是否充分,我又人工检查了100条生成答案,其中18条含有检索段落中没有的说法。这里的无依据,是指当前检索证据不支持答案中的内容,不应仅凭这一点就把它等同于医学事实错误。这一观察也只适用于已经检查的100条,不能外推为总体发生率。它提示下一步不能只继续追求检索分数,而需要单独评估答案的证据支持;负样本风险是否充分控制、长段落为什么表现下降,也仍然需要验证。
-
11下一步优先验证答案依据,同时继续长文档优化
演讲者备注
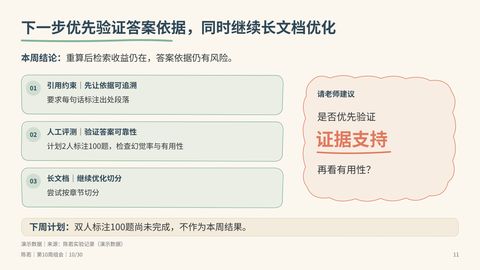
基于这个发现,我建议下周把答案依据验证放在优先位置:尝试要求每句话标注出处段落,再逐句检查引用是否真正支持对应说法,而不只看有没有引用。同时计划由两人标注100题,评估无依据内容和有用性,并继续尝试按章节切分长文档;这些都是拟开展工作,还没有结果。本周能保留的结论是,重算后检索收益仍在,困难负样本进一步改善了指标,但答案可靠性尚未解决。想请李老师和各位同学建议,人工评测是否按先证据支持、再有用性的顺序推进,谢谢大家。


文件里可以修改什么
每个字都是真实文字
标题、要点和标签都是文本框,可以改写、换样式或翻译。
图示都是形状
方框、箭头和图标都是 PowerPoint 形状,可以移动、缩放和改颜色。
图片各自独立
照片和插画都是单独的图片,可以替换或裁剪。
图表是真正的图表
每个图表的数据都保存在自己的 Excel 表里。选择“编辑数据”,输入新数字,图表就会重新绘制。
第 9 周 → 第 10 周:哪些变了,哪些不变
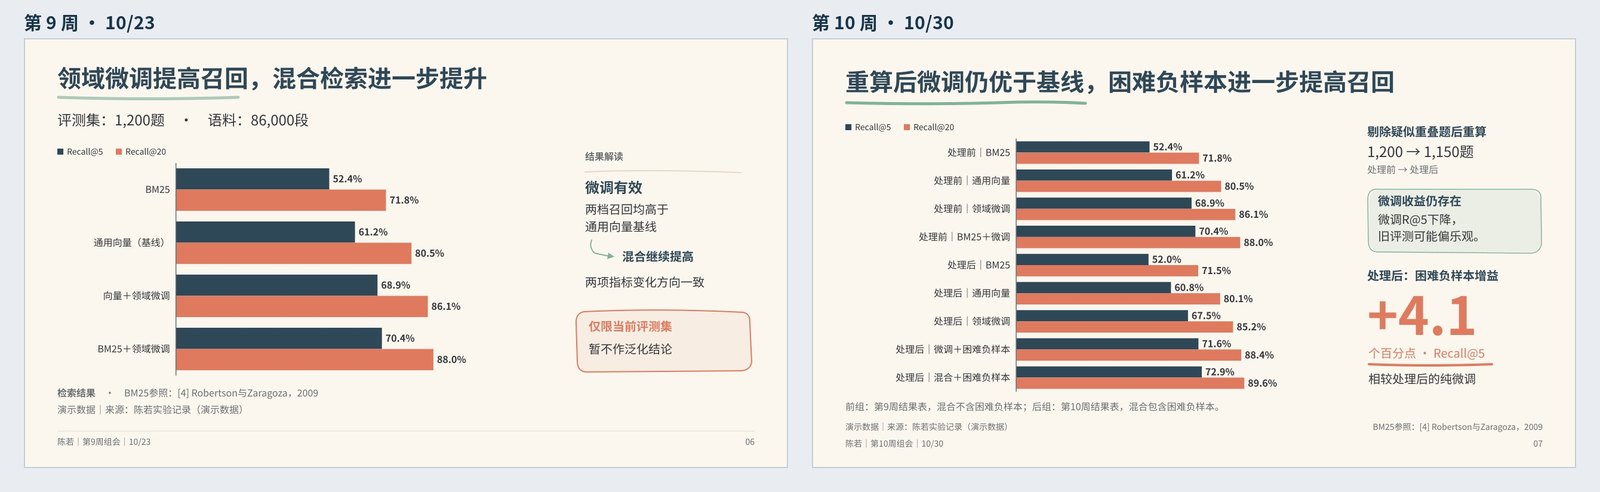
1检索结果:重算后的数字与泄漏处理前的数字并列。
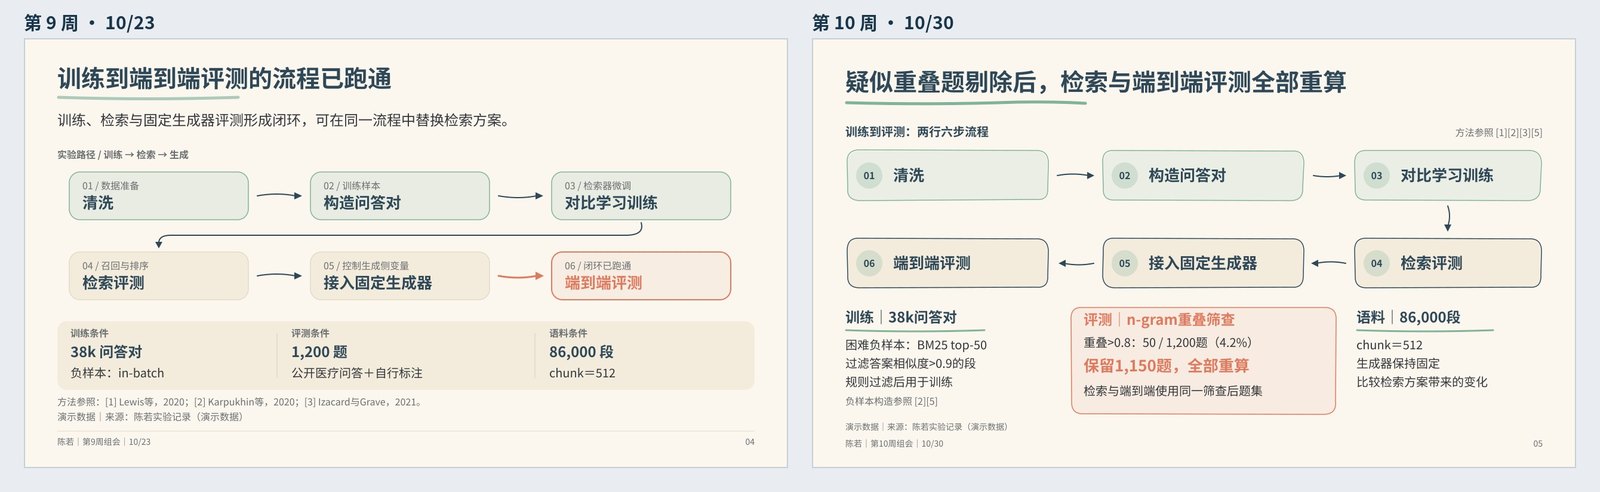
2实验流程:同一张流程图,加入本周的泄漏检查。
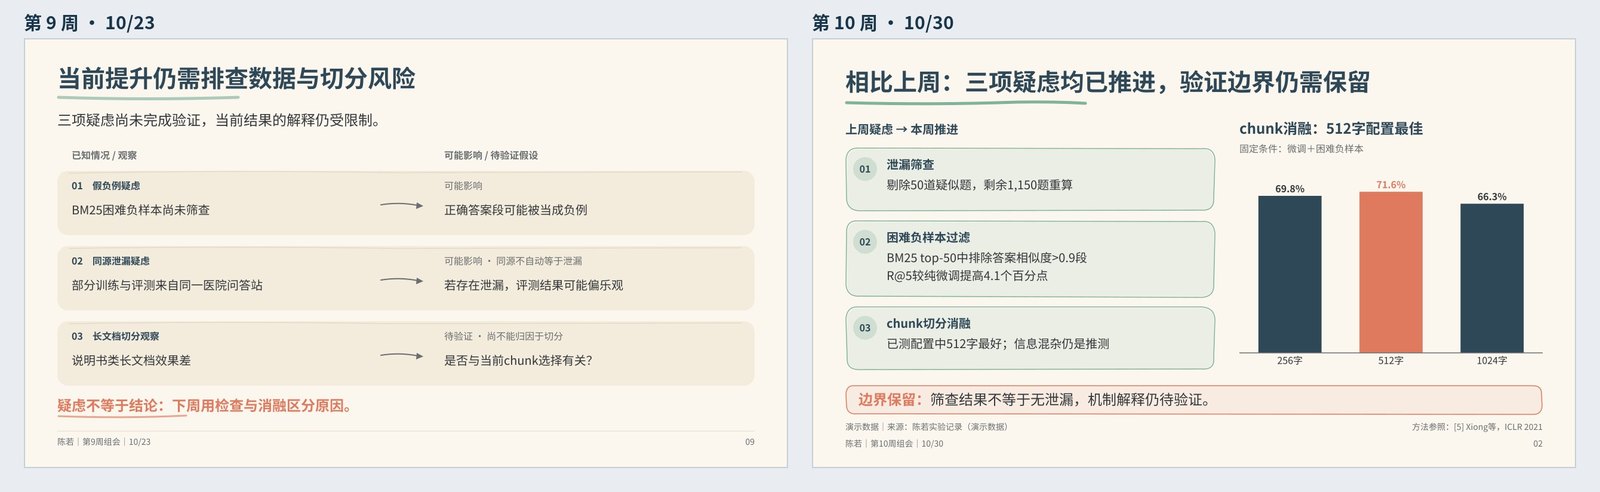
3上周的三个疑问,本周各自的进展。
 集团 AI 转型:三年投资计划与实施路线图
 家族办公室:年度投资组合回顾与风险分析
 高端消费品牌出海:市场进入与增长方案